内容持续更新中
阿里通义千问团队近日端出了一道让开源社区眼前一亮的菜:开放权重的图像生成与编辑模型Qwen-Image-2.1正式登场。最让人意外的是它的身板——视觉生成组件仅用70亿参数,却在自家的评测基准上压过了…
微软于 7 月 23 日宣布推出两款自研AI模型MAI-Image-2.5-Pro和MAI-Voice-2-Flash,均已进入公开预览阶段。两款模型分别面向高质量图像生成与高并发语音交互场景,微软强…
7 月 21 日消息,阿里发布最新图像生成基础模型 Qwen-Image-3.0。新模型支持最大 4.5k token 超长输入,可一次生成涵盖公式符号、几何图形、逻辑推导步骤等多元素融合的知识图解、…
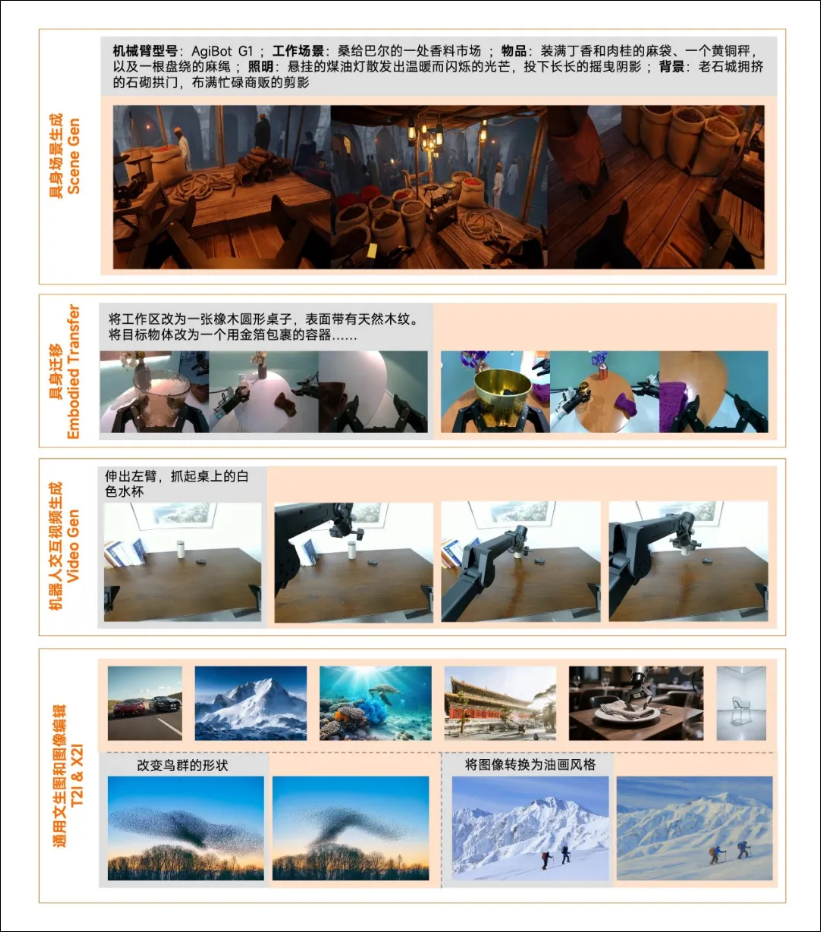
小米正式发布 Xiaomi-Robotics-U0——一个拥有 380 亿参数的多模态自回归具身生成基础模型,是具身领域首个“通吃”四类任务的统一生成模型,打通了机器人图片和视频数据的生成与编辑链路。…
晚上7点整,阶跃星辰把发布会的主题定成了”Agent时代真正的智能体”——这不是一句口号,而是一次蓄谋已久的抢跑。当OpenAI还在为AI硬件的代号Sweet Pea争论不休,…
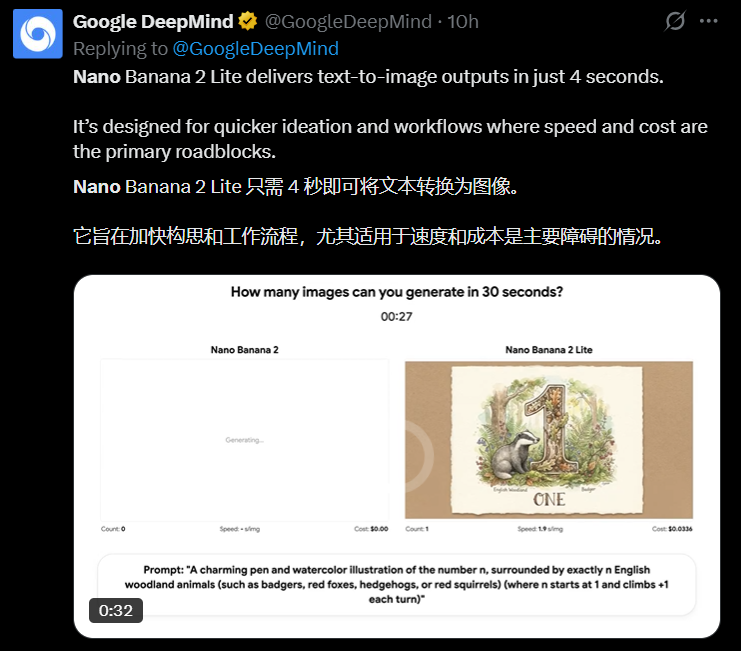
人工智能图像生成领域的竞争正变得愈发“内卷”。7月1日,谷歌正式对外发布了新一代自研 AI 图像与视频生成模型——Nano Banana2Lite。作为上一代产品的迭代之作,该模型在保持高效生成能力的…
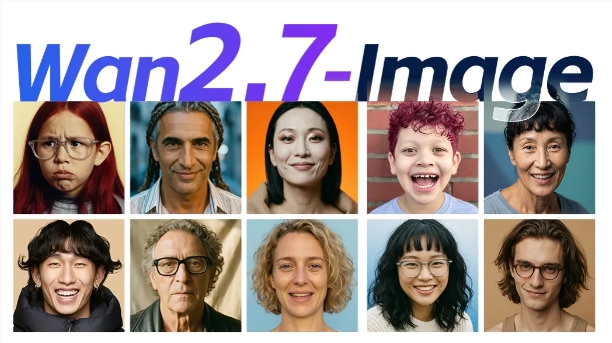
阿里大模型团队今日正式发布图像生成与编辑统一模型 Wan2.7-Image。相比前代,该模型在人像定制化、色彩控制以及长文本渲染方面实现了质的飞跃,旨在打破 AI 生成图像中常见的“千篇一律”感。 目…
3月18日,Midjourney正式发布其V8模型的早期版本。作为一次重大的架构更新,V8模型在Alpha网站上线后立即引发行业关注,其图像生成速度较前代提升约5倍。 此次更新引入了原生渲染2K分辨率…
2026年2月25日,谷歌正式宣布对其人工智能创意工作室Flow进行重大版本升级与生态整合。本次更新的核心在于将原有的图像生成实验项目Whisk与ImageFX深度嵌入 Flow 平台,标志着谷歌多模…
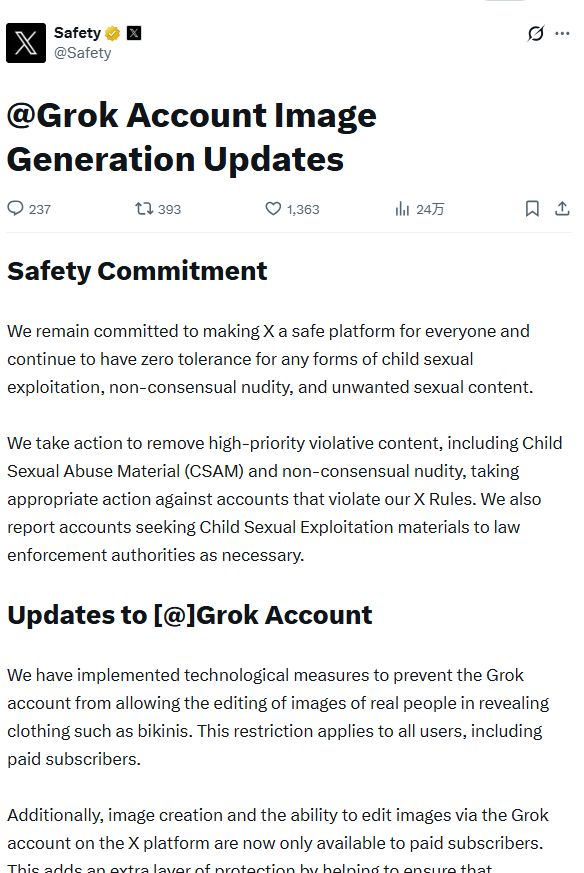
面对持续数周的舆论压力,埃隆·马斯克旗下的 X 平台今日宣布,将正式收紧其人工智能助手Grok的图像编辑与生成功能。此前,该模型因被指控生成涉及儿童的性化图像及未经许可的裸露内容,引发了全球范围内的广…
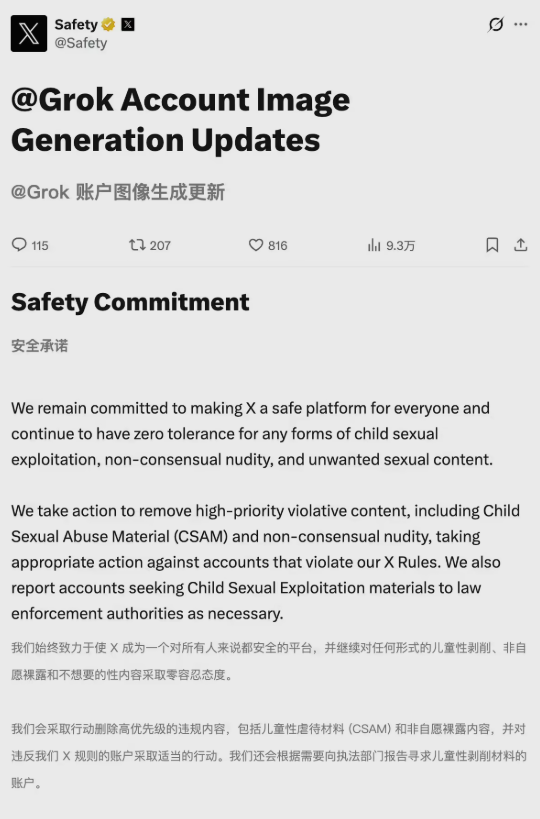
在持续数周的舆论风暴与监管压力下,X平台(原Twitter)于今日凌晨通过其官方安全账号@Safety宣布,对旗下AI模型Grok的图像生成与编辑功能实施史上最严格限制。此举直接回应了近期多起关于Gr…
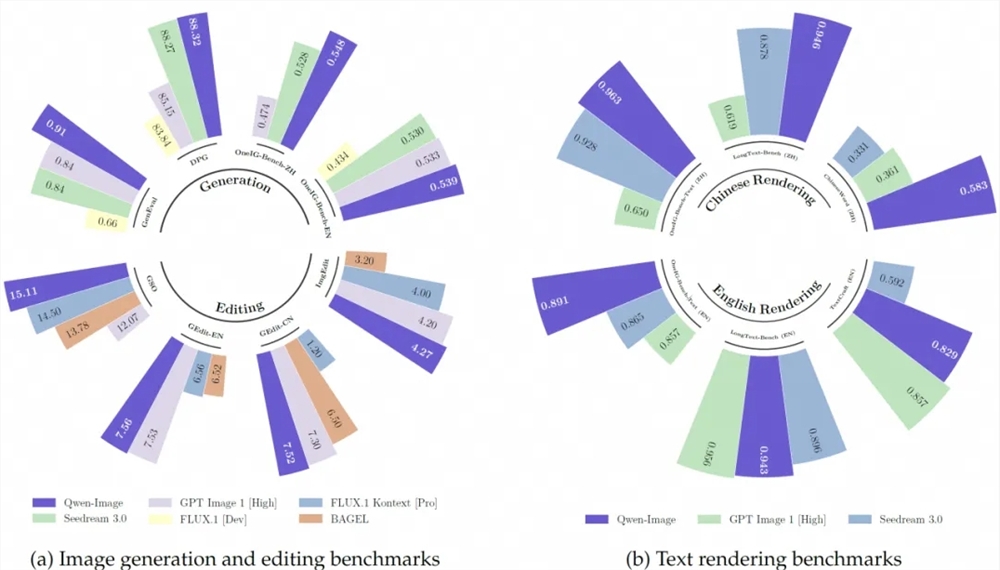
通义千问系列首次开源了一款名为Qwen-Image的20亿参数多模态扩散变换器(MMDiT)图像生成基础模型。这一创新成果不仅在复杂文本渲染和精确图像编辑方面取得了突破性进展,更是在多个公开基准测试中…
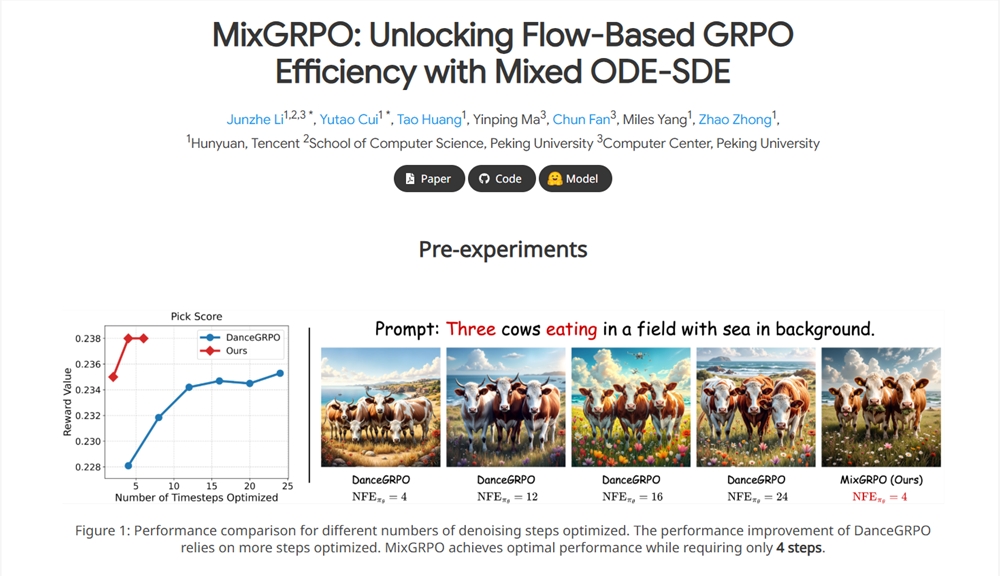
近日,腾讯的混元基础模型团队发布了一项突破性的图像生成新框架 MixGRPO。这一方案不仅将训练时间缩短了近50%,而且在性能上表现优异,甚至推出了一个名为 MixGRPO-Flash 的变体,进一步…
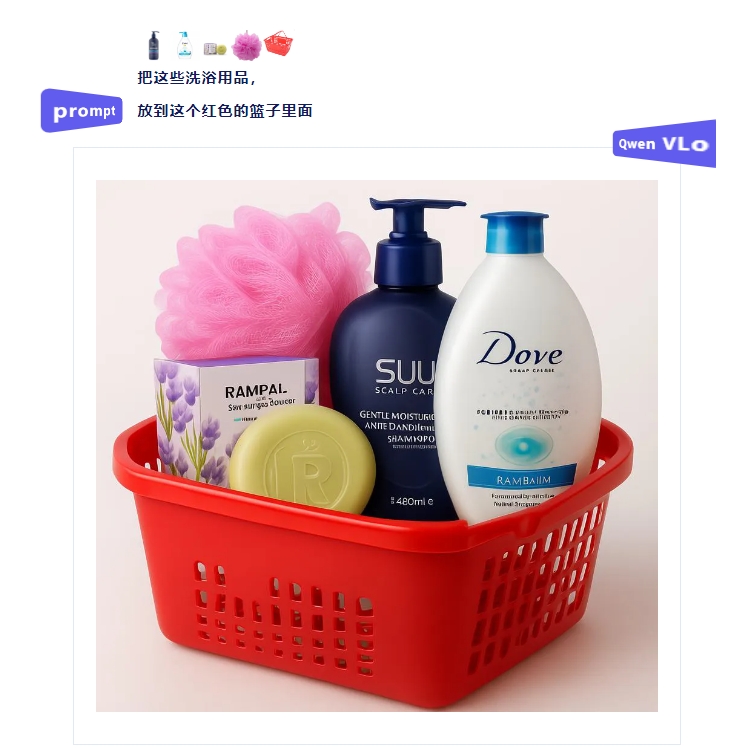
近日,Qwen VLo多模态大模型正式发布,该模型在图像内容理解与生成方面取得了显著进展,为用户带来了全新的视觉创作体验。 据介绍,Qwen VLo在继承原有Qwen-VL系列模型优势的基础上,进行了…
近日,像素蛋糕公司自主研发的 “方糖大模型” 正式通过国家网信办的备案,成为国内影像行业首个获得官方资质的应用级图像大模型。这一成就不仅标志着方糖大模型在技术上的突破,也显示了其在安全性和规范性方面达…
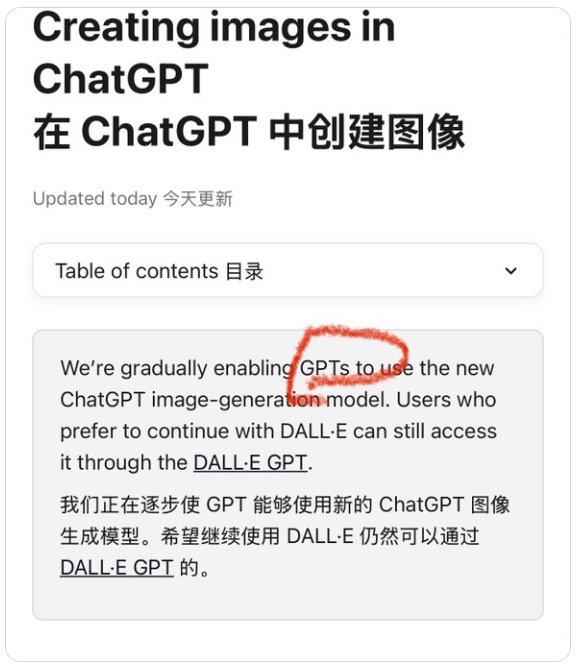
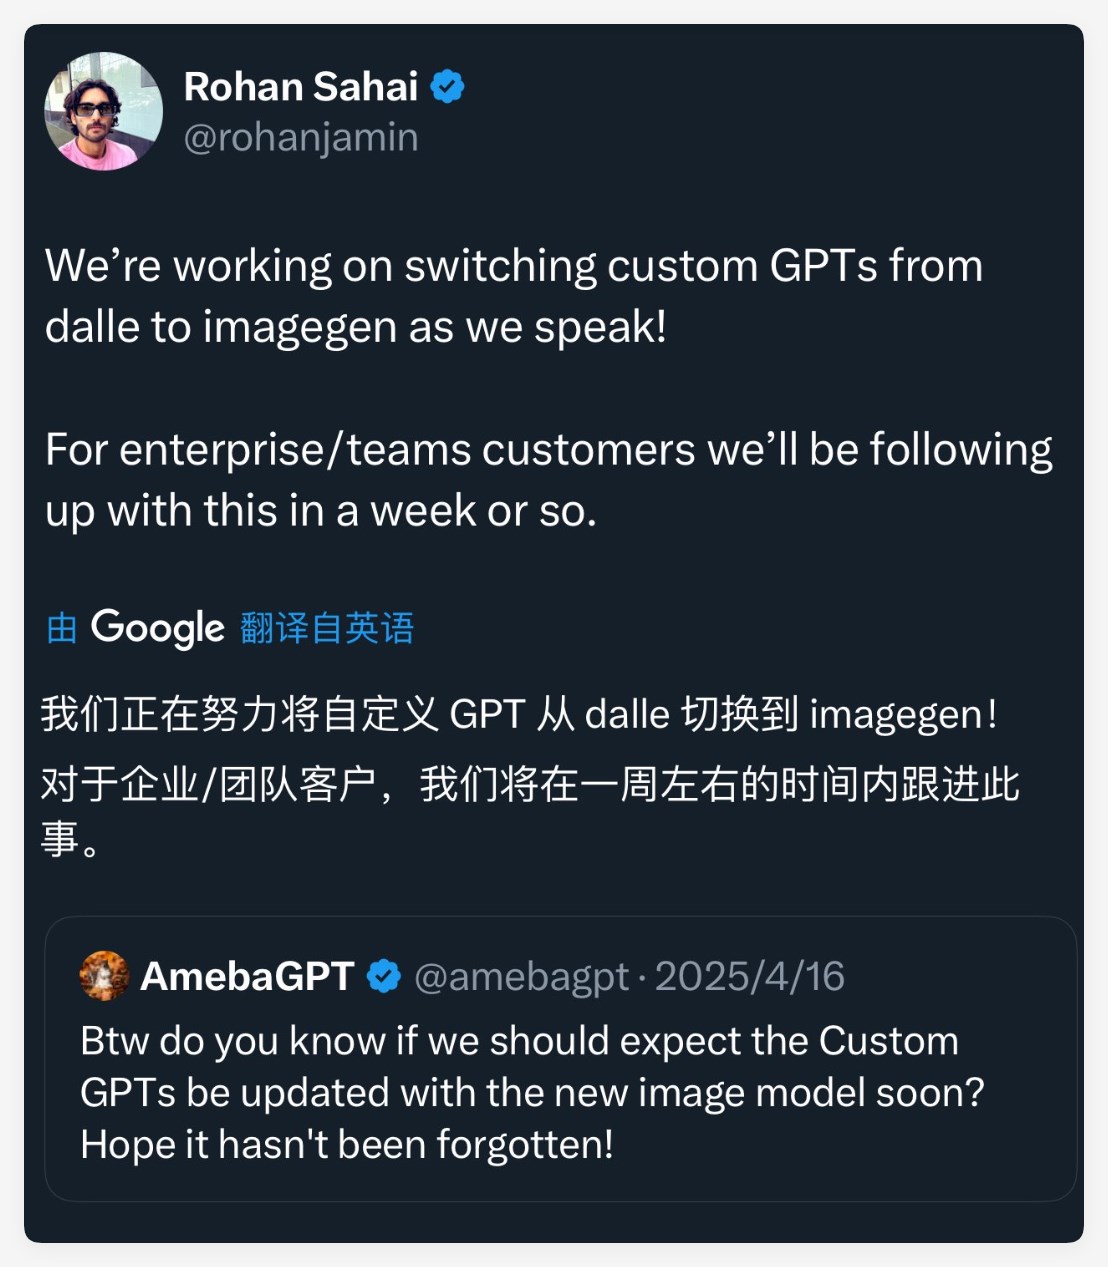
OpenAI宣布GPT-4o的图像生成能力正式集成到GPTs(自定义GPT)平台,为开发者与创作者提供了构建个性化图像生成机器人的强大工具。据AIbase了解,这一更新允许用户通过GPTs打造专属图像…
2025年4月26日 AIbase报道:OpenAI近日宣布,其旗舰多模态模型GPT-4o的图像生成功能现已正式集成至ChatGPT的自定义GPTs功能中。这一更新标志着用户创建的定制化AI助手能够直…
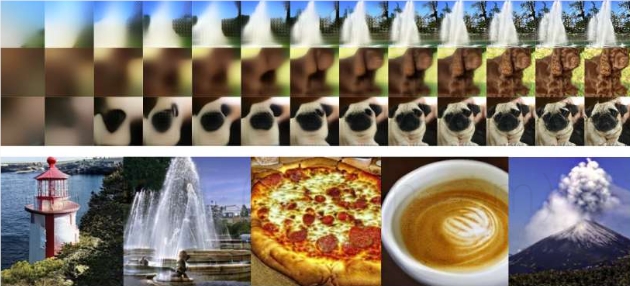
在图像生成领域,技术的进步不断推动着虚拟现实等应用的发展。最近,三星研究院提出了一种基于自回归建模的新方法,旨在提升图像生成的保真度和可扩展性。与传统的一次性生成整个场景的方法不同,该方法采用了逐步添…
近日,ChatGPT 凭借其全新的图像生成功能,迎来了一波前所未有的用户增长,成为互联网热议的焦点。根据 SensorTower 的数据,上周该应用的活跃用户数、应用内订阅收入和下载量均创下历史新高,…
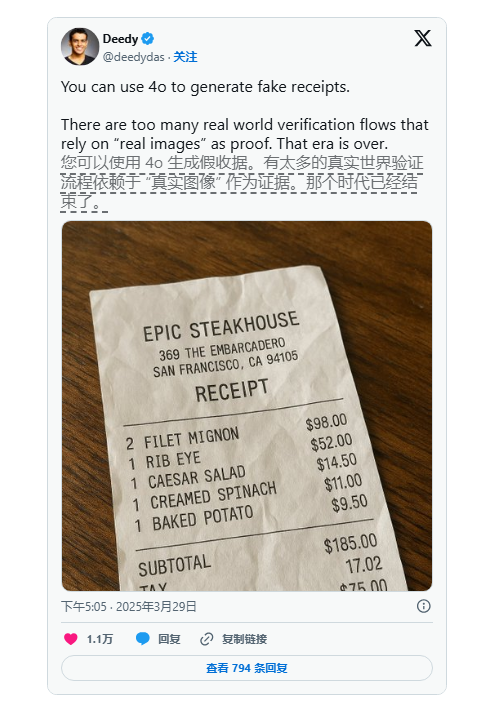
ChatGPT最新推出的4o模型图像生成功能正在引发安全忧虑,尤其是在生成逼真文本方面的进步可能为欺诈者提供新工具。社交媒体上已经出现多个用户利用该功能创建假餐厅收据的案例,这些收据看起来足以假乱真。…
OpenAI 首席执行官萨姆・阿尔特曼在社交媒体上宣布,ChatGPT 新推出的图像功能的上线时间将推迟,原因是用户的需求远远超出了公司的预期。阿尔特曼表示:“ChatGPT 中的图像功能比我们想象的…
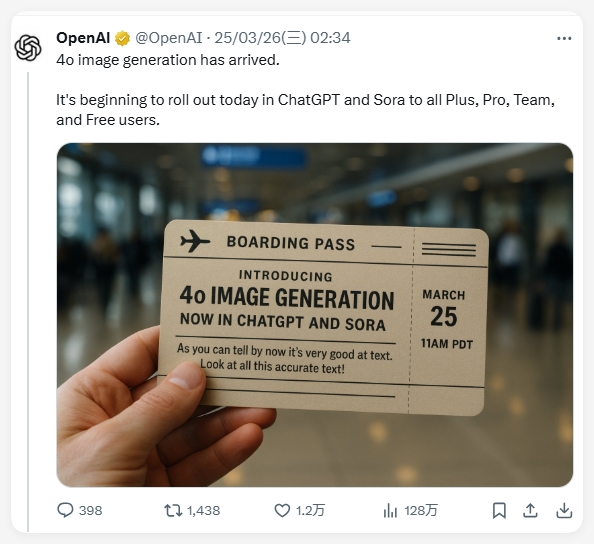
2025年3月25日,OpenAI宣布其最新图像生成模型正式内置于GPT-4o中,这一突破性升级为用户带来了更强大的图像生成与编辑体验。据悉,该功能已于今日开始向ChatGPT和Sora的所有Plus…
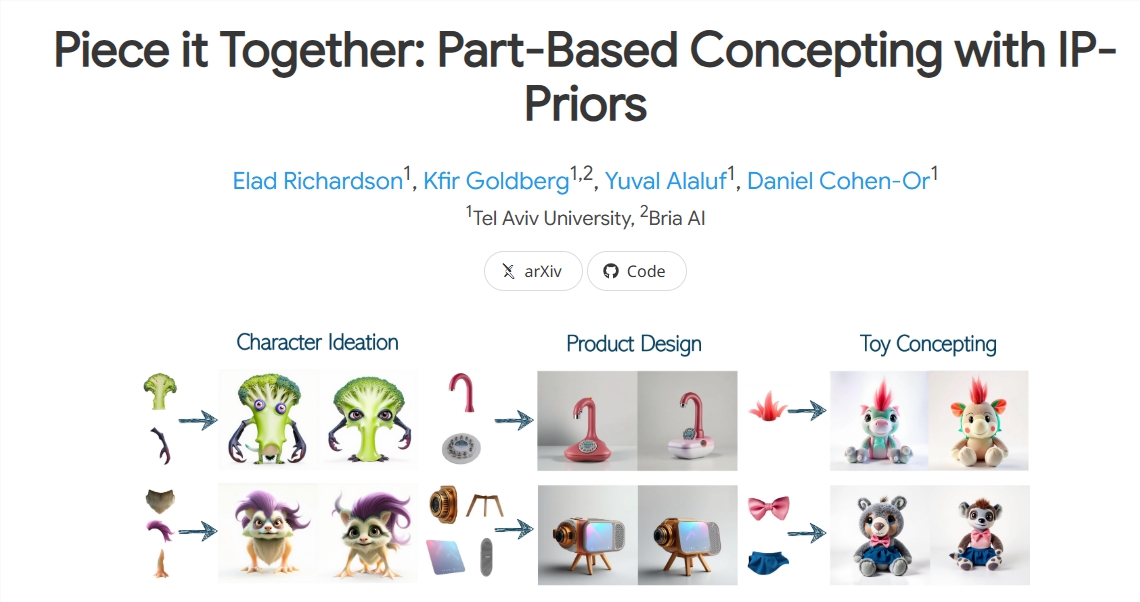
近日,PiT(基于视觉零件的图像生成框架)这一全新技术在人工智能领域备受瞩目。此创新框架能凭借输入的零散图像片段,智能地“脑补”出完整图像,从而为图像生成技术带来重大突破。无需依赖传统文字提示,PiT…
近期,谷歌推出的 Gemini 2.0 Flash 模型在社交媒体上引发了争议。用户发现,该模型能够去除图片中的水印,包括来自盖蒂图片社(Getty Images)等知名图库的图片水印。 上周,谷歌扩…
随着AI技术的不断发展,其生成的文章、图片和视频作品越来越多,比如我们在刷短视频时,常常会看到这样的提示:内容疑似ai生成。每次看到这,有人难免产生疑问,平台是怎么识别出来的?肉眼看到的明明是真人啊,…
2025第一季度,文生图行业进步神速。 直观层面,图形的拟真度飞速提升。由此,其在广告、宣传、影视制作、游戏开发等领域的价值得到了空前开发。 而AI的发展不会到此为止。为了降低制作成本和时间,提高工作…
14 日消息,科技媒体 MacRumors 昨日(3 月 13 日)发布博文,报道称 OpenAI 公司已向美国政府提交一份 AI 发展建议书,呼吁放宽监管,让 AI 公司自由使用受版权保护的材料,训…
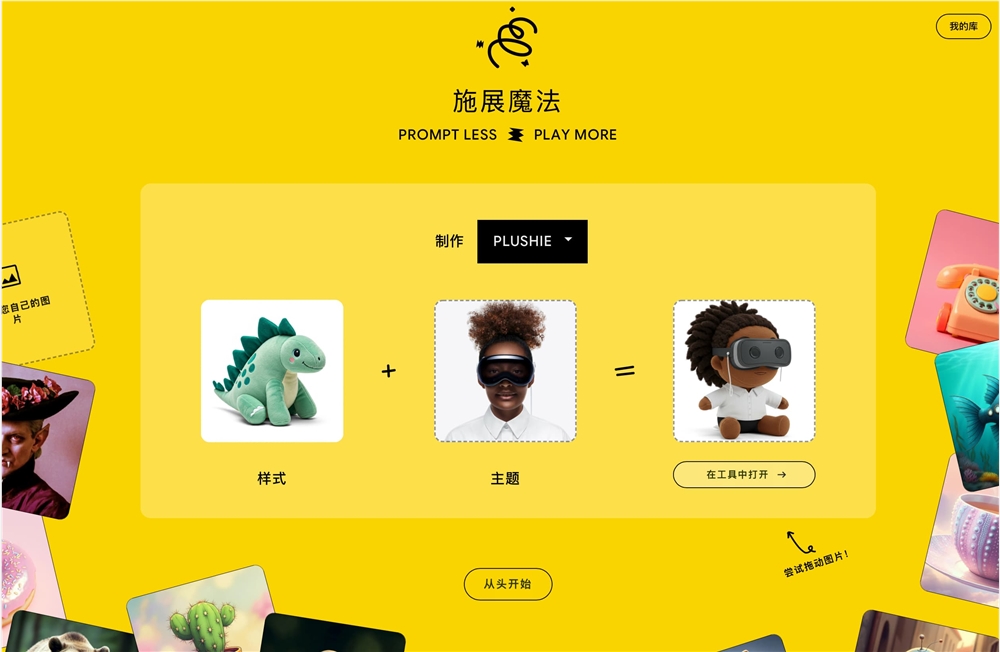
谷歌近日宣布,其基于人工智能的图像混合工具Google Whisk已在全球100多个国家/地区正式推出。这款工具最初于去年在美国发布,旨在通过创新的图像混合技术,为用户提供更简单、更具创意的图像生成体…